Agent2API 是一个把「AI 桌面客户端里已登录的账号」聚合成一个 OpenAI 兼容接口的自托管网关。它不需要上游 API Key,客户端填一个 base_url 就能用这些账号的模型额度。
它解决什么问题
日常会遇到这种情况:手上有 WorkBuddy、Qoder、Trae、Cline 这类桌面客户端的登录态,额度分散在各家,想在自己的脚本或别的客户端里复用时,得挨个去对接协议。Agent2API 的思路是:把这些登录态收进一个本地网关,对外只暴露一套 http://127.0.0.1:3065/v1 的 OpenAI 兼容接口,Chat / Responses / Messages 三种协议都吃。
它自带 17 家提供商的适配,支持凭证自动续期、多账号轮转、每账号独立出口代理、请求报表和定时签到。对我最实用的点是:任何支持自定义 base_url 的客户端都能直接接进来,包括我自己在跑的 Hermes Agent。
第一步:部署
最简单的办法就是让ai agent帮你部署项目,复制下面的内容让你的agent帮你安装
https://github.com/aimod-cc/agent2api 帮我安装此项目第二步:添加模型提供商账号
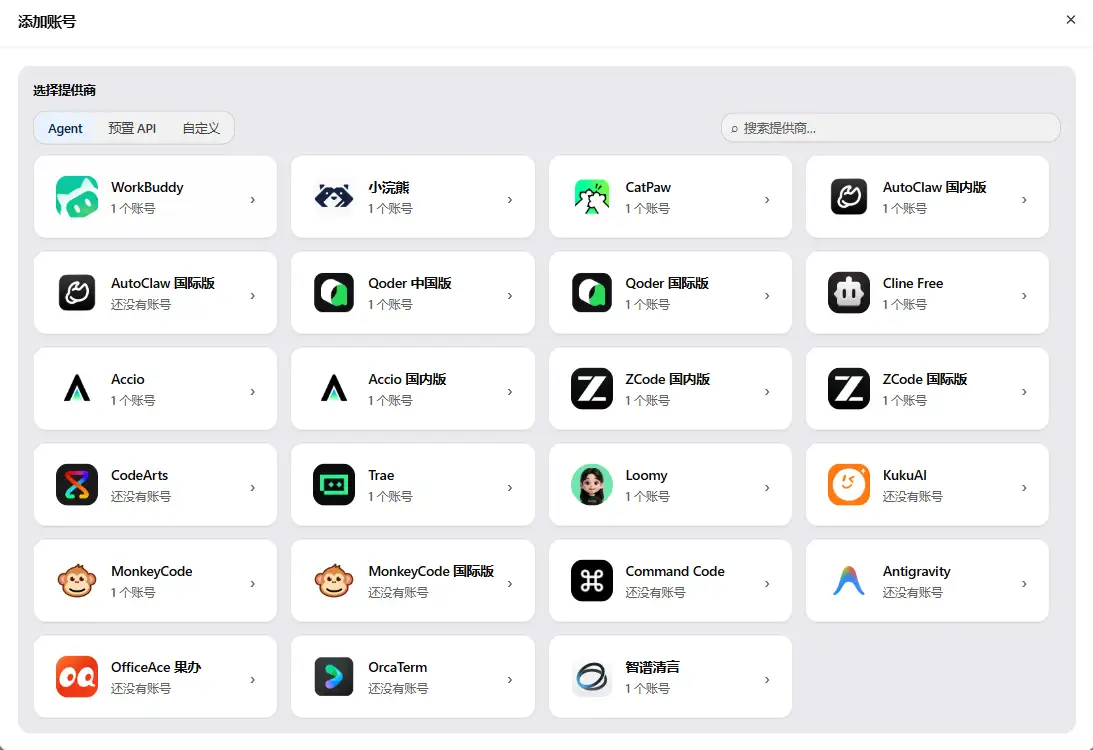
目前支持的模型提供商如图所示,按流程接入账号即可
第三步:建网关 Key,接入客户端
登录面板后到「网关 Key」页生成一把 Key。没建 Key 之前网关是 fail-closed 的,转发表面通、实际拒绝转发,这是设计上的安全默认值。
之后任何 OpenAI 兼容客户端这样填:
base_url = https://你的域名/v1
api_key  = sk-你生成的那把
定时签到功能
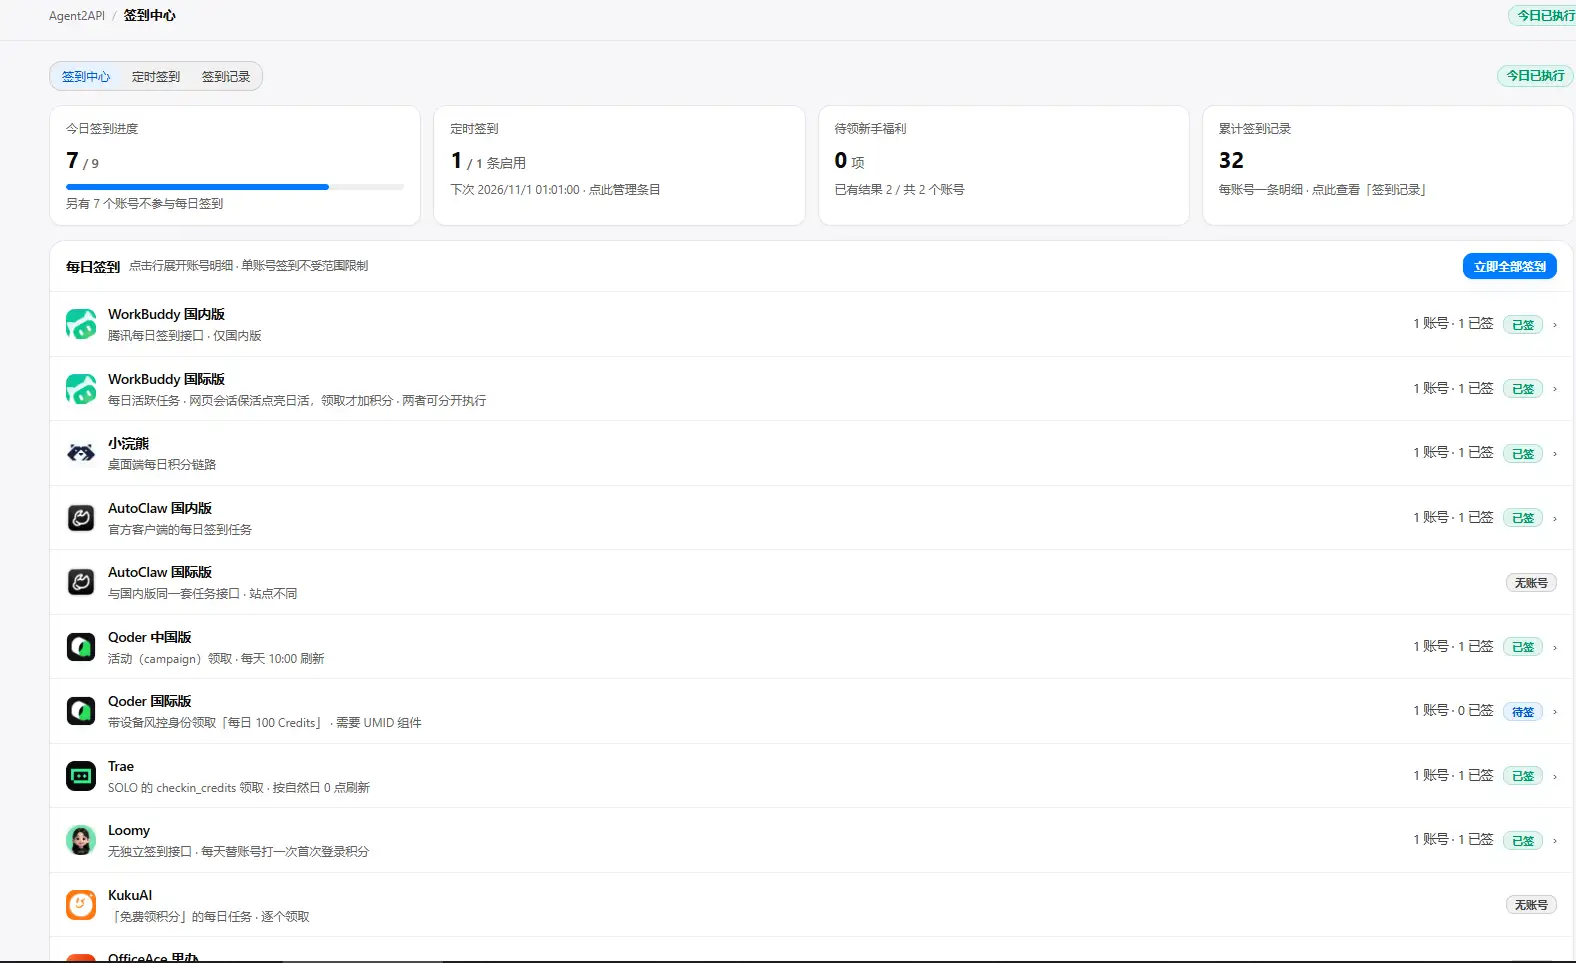
agent2api支持定时签到和workbuddy的派猫猫去旅行,在签到中心配置即可
模型管理
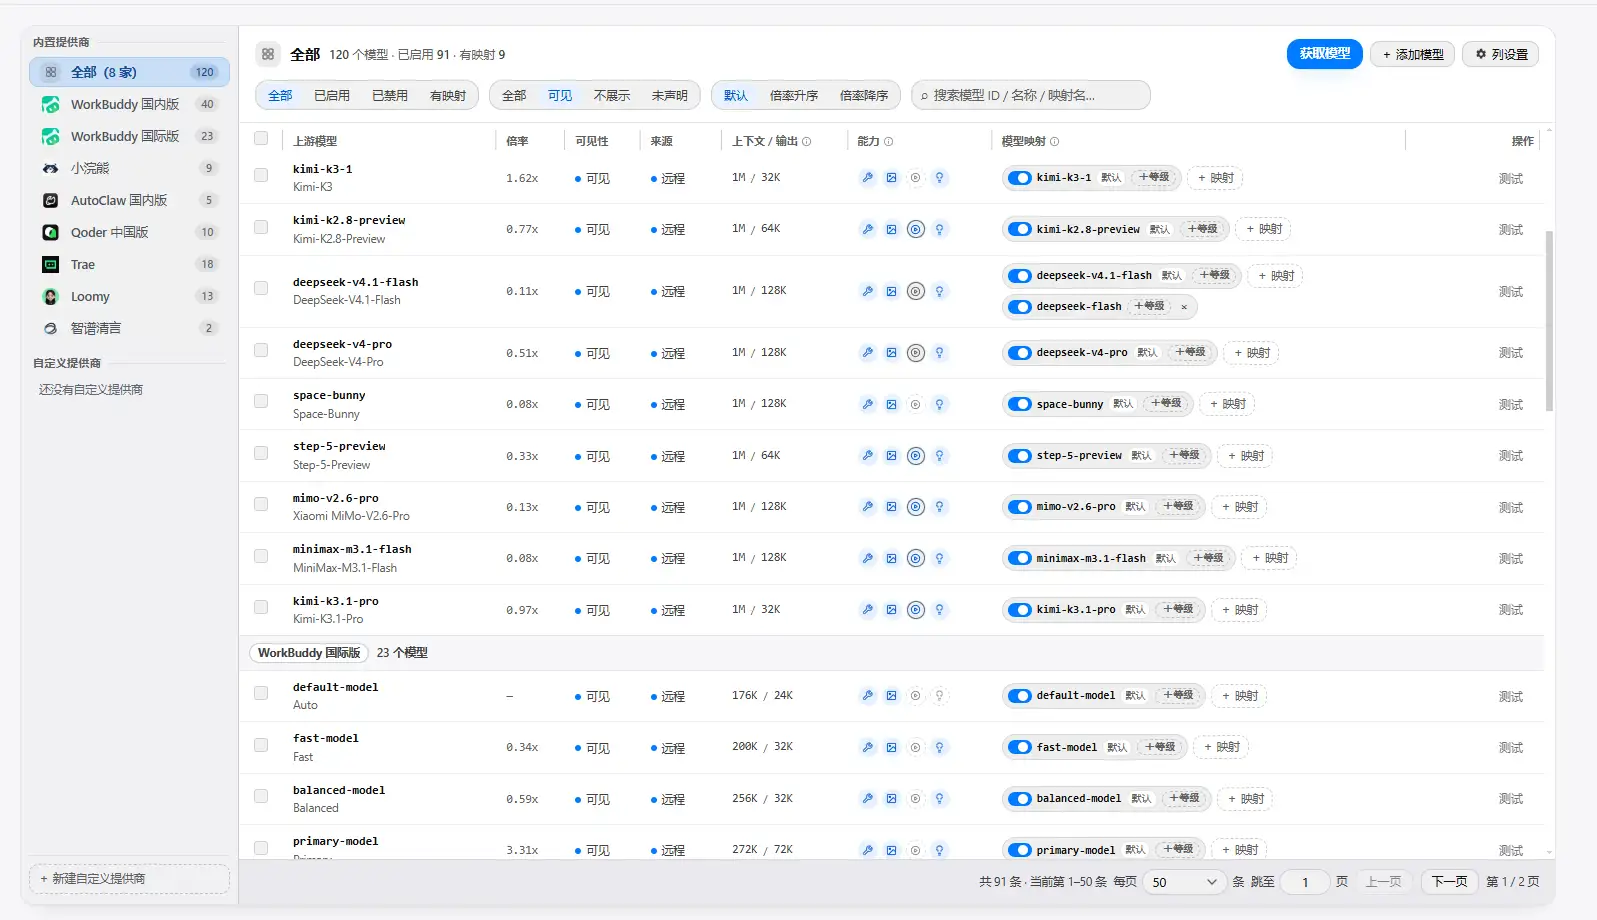
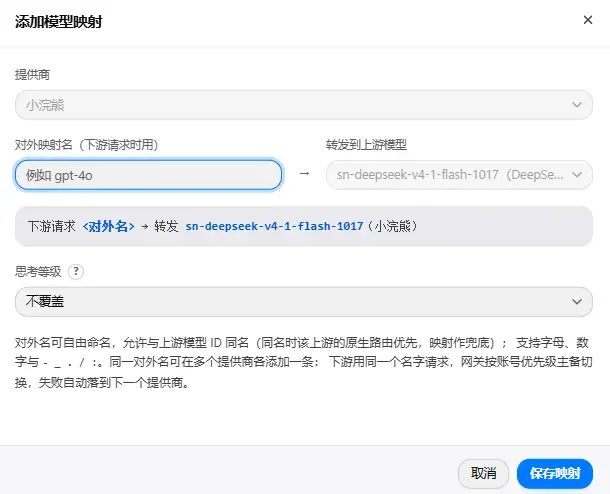
模型管理页面可以映射模型名称,比如有些提供商给的模型名称是sn-deepseek-v4-1-flash-1017 有些是deepseek-v4-1-flash-1017 可以映射一个统一的名称
实测性能
部署完顺手测了下吞吐(流式,统计从首 token 到结束的生成速率):
| 场景 | 输出 tokens | 首 token 延迟 | 生成速度 |
|---|---|---|---|
| 短 prompt,900 tokens | 901 | 1.75s | 151 tok/s |
| 同规模复测 | 900 | 1.95s | 153 tok/s |
| 长输出,4000 tokens | 4000 | 1.49s | 167 tok/s |
另外测了一次大输入:13,217 tokens 的 prompt,2.2 秒返回,prefill 速率约 6k tok/s。首 token 延迟稳定在 1.5~2 秒,不随输出长度增长,说明 nginx 反代加容器本地转发这一层基本没有引入额外开销。
小结
整个部署从拉镜像到 HTTPS 可用大概十几分钟
上线后的体验是:一个域名、一把 Key、一套 OpenAI 兼容接口,桌面客户端里的那些额度就变成了我脚本里可以直接调的东西。至于额度够不够用,取决于面板里挂的上游账号,这就不在网关的能力范围内了。
CONVERSATION
暂无评论